El volumen que tres contenedores quisieron poblar a la vez
mkdir file exists en medio de vendor/. La imagen estaba bien, el codigo estaba bien, y el error era que app, queue y scheduler arrancaron al mismo tiempo sobre un volumen vacio.
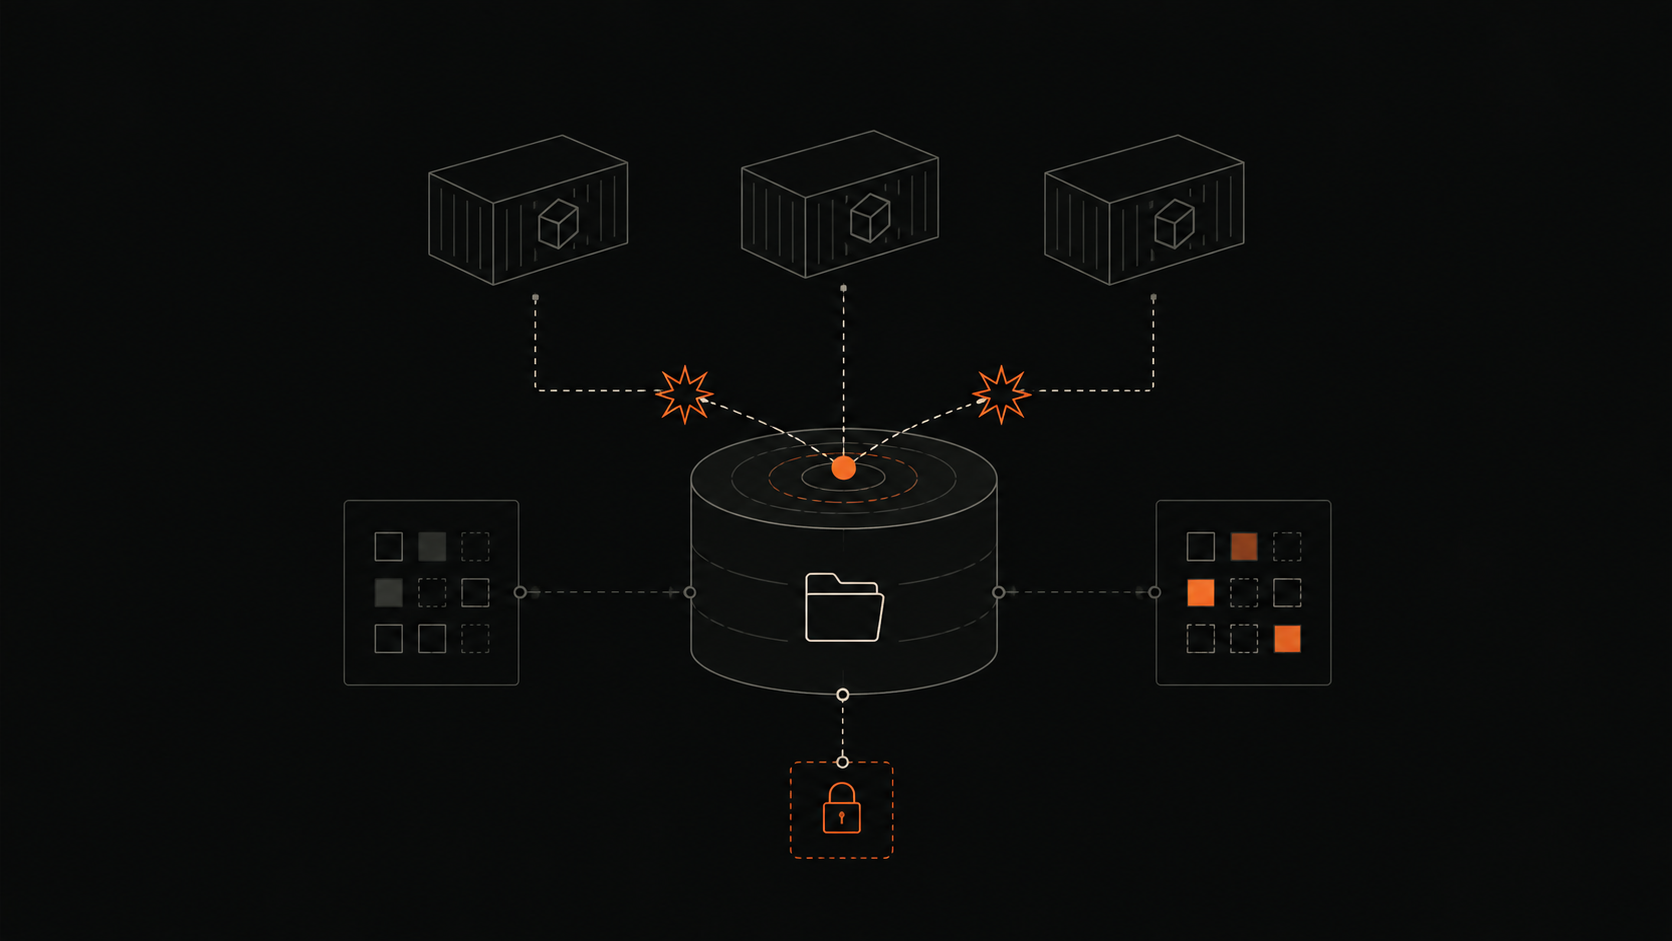
Primer arranque de una aplicación nueva. La imagen se construyó sin problemas, las tres capas del Dockerfile pasaron, y al levantar:
Error response from daemon: failed to mkdir
/var/lib/docker/volumes/hm-agency_appcode/_data/vendor/laravel/framework/
src/Illuminate/Contracts/Console: file exists
Un mkdir que falla porque el directorio ya existe, en medio de vendor/, sobre un volumen que acababa de crearse vacío.
Qué está pasando de verdad
Docker tiene un comportamiento que se usa todo el tiempo y casi nunca se explica: cuando montas un volumen nombrado sobre una ruta que en la imagen ya tiene archivos, y el volumen está vacío, Docker copia el contenido de la imagen al volumen antes de arrancar el contenedor.
Es lo que hace que este patrón funcione:
volumes:
  - appcode:/var/www/html
La aplicación queda en un volumen, nginx puede montarlo de solo lectura, y todos ven el mismo código.
El problema es que mi stack tiene tres contenedores de PHP montando ese mismo volumen: la aplicación, el trabajador en cola y el programador. Los tres arrancaron a la vez. Los tres vieron un volumen vacío. Y los tres empezaron a copiar vendor/ al mismo lugar.
Docker copia directorio por directorio. Dos procesos llegaron al mismo mkdir con milisegundos de diferencia: el primero lo creó, el segundo se encontró con que ya existía y abortó.
No es un error del código, ni de la imagen, ni del Dockerfile. Es una carrera.
Por qué no te pasa siempre
Esto es lo que lo hace molesto de diagnosticar: depende del tiempo. Con un vendor/ pequeño la copia es tan rápida que el primer contenedor termina antes de que el segundo empiece. Con 7,949 archivos, la ventana se abre.
Por eso el mismo compose.yml te funciona en cuatro proyectos y falla en el quinto, y por eso volver a intentar a veces "lo arregla" — con el volumen ya poblado, no hay nada que copiar y nadie se pisa.
Ese "a veces funciona" es justo lo que hay que no aceptar como solución.
El arreglo
Que solo uno pueble el volumen. En compose.yml, los otros dos esperan:
  hm-app:
    build: { context: ., target: runtime }
    depends_on:
      db: { condition: service_healthy }
    volumes:
      - appcode:/var/www/html

  hm-queue:
    build: { context: ., target: runtime }
    depends_on:
      db: { condition: service_healthy }
      hm-app: { condition: service_started }   # <-- esto
    volumes:
      - appcode:/var/www/html
service_started no espera a que la aplicación esté lista, solo a que el contenedor haya arrancado — y arrancar, para Docker, es después de poblar el volumen. Que es exactamente la garantía que hacía falta.
Si el volumen ya quedó a medias, hay que vaciarlo. Y aquí conviene ser quirúrgico:
docker compose down
docker volume rm hm-agency_appcode    # SOLO ese
docker compose up -d hm-app           # que lo pueble el solo
docker compose up -d                  # y ahora el resto
Solo appcode. En el mismo stack viven pgdata con la base y storage con los archivos que subieron los usuarios. Un docker volume prune distraído a esa hora se lleva lo que no se puede reconstruir.
Se comprueba mirando lo que quedó dentro:
$ docker exec hm-app sh -c 'find vendor -type f | wc -l'
7949
Lo que se queda de esto
El volumen de código es cómodo y tiene dos filos. El otro —el que muerde en el segundo despliegue, no en el primero— es que Docker solo copia cuando el volumen está vacío. Publicas código nuevo, reconstruyes la imagen, levantas... y el sitio sigue sirviendo el código viejo, sin un solo error en ningún registro.
Por eso mi guion de despliegue borra ese volumen a propósito en cada vuelta:
docker compose build
docker compose down
docker volume rm hm-agency_appcode
docker compose up -d
Parece agresivo. Es lo contrario: es la única forma de que lo que corre sea lo que acabas de construir.