Monitorear lo que no responde 200: cuando el 302 es la buena noticia
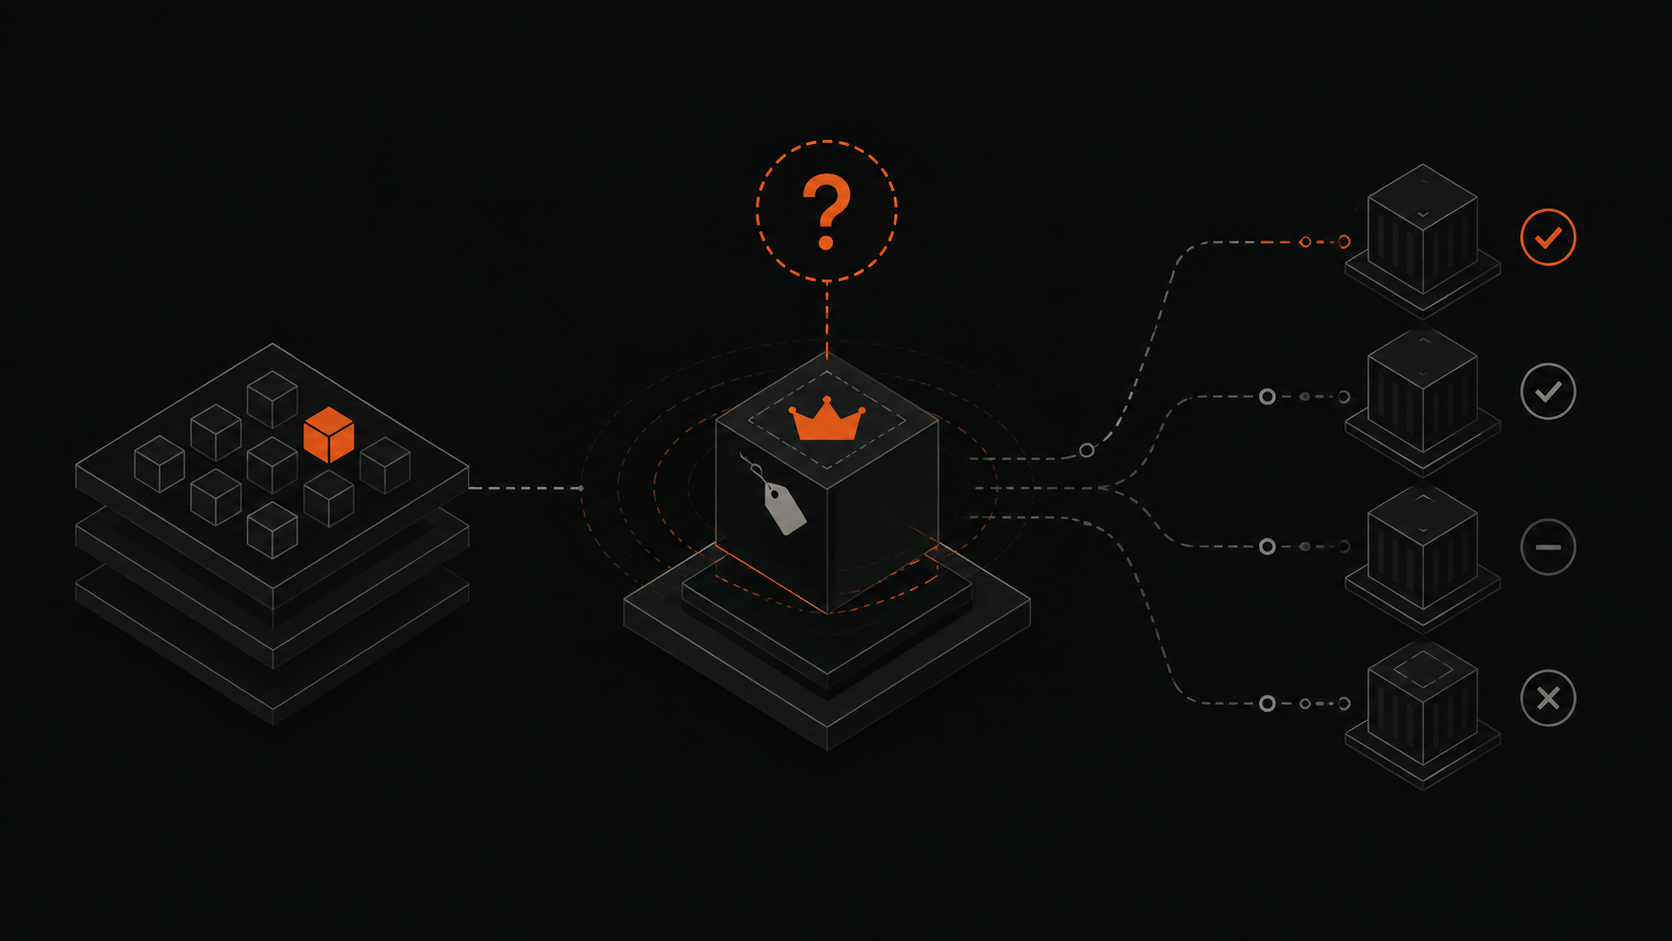
Di de alta seis monitores con los codigos de fabrica y cinco salieron caidos. Ninguno lo estaba: un login que redirige, una API que exige llave y un S3 que niega el listado no responden 200 y hacen bien.
Levanté Uptime Kuma, di de alta seis monitores con la configuración de fábrica y me fui a dormir. A la mañana siguiente tenía cinco servicios en rojo y todos funcionaban perfectamente.
La configuración de fábrica acepta como sano el rango 200-299. Casi ninguna aplicación de verdad contesta eso en su raíz.
Lo que contesta cada uno, y por qué
Estos son los códigos reales de mis servicios:
| Servicio | Código | Por qué |
|---|---|---|
| Tres plataformas Laravel | 302 | La raíz redirige al login |
| Microservicio en Java | 401 | Exige credenciales, y hace bien |
| Almacenamiento S3 | 403 | Niega el listado del bucket raíz |
| Netdata | 400 | Su servidor no atiende HEAD |
Los cuatro son la respuesta correcta. Un Laravel con autenticación que devolviera 200 en / estaría enseñando algo que no debería. Una API que devolviera 200 sin llave sería el problema, no la solución.
O sea que el monitor de fábrica no está midiendo si el servicio vive. Está midiendo si el servicio es público y anónimo — que es justo lo contrario de lo que uno quiere.
El arreglo es decirle a cada monitor qué esperar. En Uptime Kuma, el campo Accepted Status Codes: 302 para las plataformas, 401 para la API, 403 para S3.
El 400 de Netdata, que es otro caso
Este merece aparte porque el error no está en el monitor sino en el método. Muchas herramientas comprueban con HEAD en vez de GET, porque es más barato: pides las cabeceras y no el cuerpo.
El servidor web de Netdata no implementa HEAD y contesta 400. No está caído; le hablaste en un idioma que no habla.
Se ve claro comparando:
$ curl -I -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:19999/
400
$ curl -s -o /dev/null -w '%{http_code}\n' http://127.0.0.1:19999/
200
Cuando un monitor insista en dar un código raro, comprobar a mano con GET antes de investigar el servicio ahorra la tarde.
Comprobar la ruta correcta
Aprovechando que hay que tocar cada monitor, conviene apuntarlo a algo que signifique algo. La raíz de una aplicación de Laravel te dice que nginx y php-fpm están vivos, y nada más. Si la base se cayó, la raíz puede seguir dando 302 tan campante.
Laravel trae desde hace unas versiones una ruta pensada para esto:
$ curl -s -o /dev/null -w '%{http_code}\n' https://mi-app.ejemplo.dev/up
200
/up ejecuta la aplicación de verdad. Es más honesto que la portada, y encima responde 200, así que el monitor se configura solo.
La limitación que hay que asumir
La mía vive en el mismo servidor que vigila. Eso significa que detecta perfectamente una aplicación caída, un contenedor que no arranca o un certificado por vencer — y no detecta nada el día que se cae la máquina, porque se cae con ella.
Lo sé y lo acepto, porque el 90% de mis incidentes son del primer tipo. Pero es una frase que hay que poder decir en voz alta: mi monitoreo no me va a avisar del peor caso. Si eso no es tolerable, el monitoreo tiene que vivir en otra parte.
Lo que sí hice fue no exponerlo. El panel no escucha en internet: solo en la dirección de mi red privada, así que llego a él desde el celular sin abrir un puerto al mundo.
Y ahí un detalle de Docker que cuesta un rato: un servicio publicado como 127.0.0.1:3001 no se alcanza por la IP de la red privada. Son interfaces distintas. Hay que publicarlo explícitamente en esa dirección:
ports:
  - "100.99.206.97:3001:3001"    # y no "127.0.0.1:3001:3001"
Publicarlo en 0.0.0.0 tampoco es la salida: los puertos que publica Docker se saltan el firewall del sistema, y el panel acabaría en internet sin que nadie lo note.
Lo que quedó
Seis monitores, cada uno con el código que le toca, apuntando a rutas que ejercitan la aplicación. Cero alertas falsas desde entonces.
Un monitoreo que da alarmas falsas es peor que no tener monitoreo: en un mes ya nadie lee los avisos, y el día que uno es de verdad, tampoco.